免费无限大模型靠谱吗:限流、代扣费、拿去训练,3 个坑实测清单
有一类事故在开发者社区被反复提起,描述得很有画面感:demo 跑得很爽、上线第三周突然全线报错。
原因通常不是模型变笨了,而是撞上了两件没被写进注意力的事:免费档有每分钟/每日的双重限流,真实并发一进来就 429;或者你调的那个接入方式是「先用免费额度、用完自动按 token 计费」,额度一过线就开始扣钱(奇连 AI、CSDN 免费 API 限额实测整理,2026)。
所以「免费无限大模型靠谱吗」这个问题,得拆成三问:免费的是什么、限的是什么、拿什么换。
先把三样「免费」分开
很多被叫作「免费 API」的东西,其实是三种完全不同的东西(奇连 AI 的整理讲得最清楚):
- 长期免费的模型档位:只有这一类能写进技术方案。
- 新用户注册赠送的一次性额度:本质是有期限的预付。
- 订阅套餐里包含的用量:你已经在付钱了。
分不清这三者,就会出现「demo 跑得很爽、上线第三周突然全线报错」的经典事故。
⚠️ 避坑:别把限时当永久做规划。有平台的免费档明确写3 个月过期;还有平台把免费模型目录一夜从十几个砍到只剩两个(掘金「我接了 12 个免费大模型,坑替你踩了」,2026)。免费的东西,平台没有义务给你稳定。
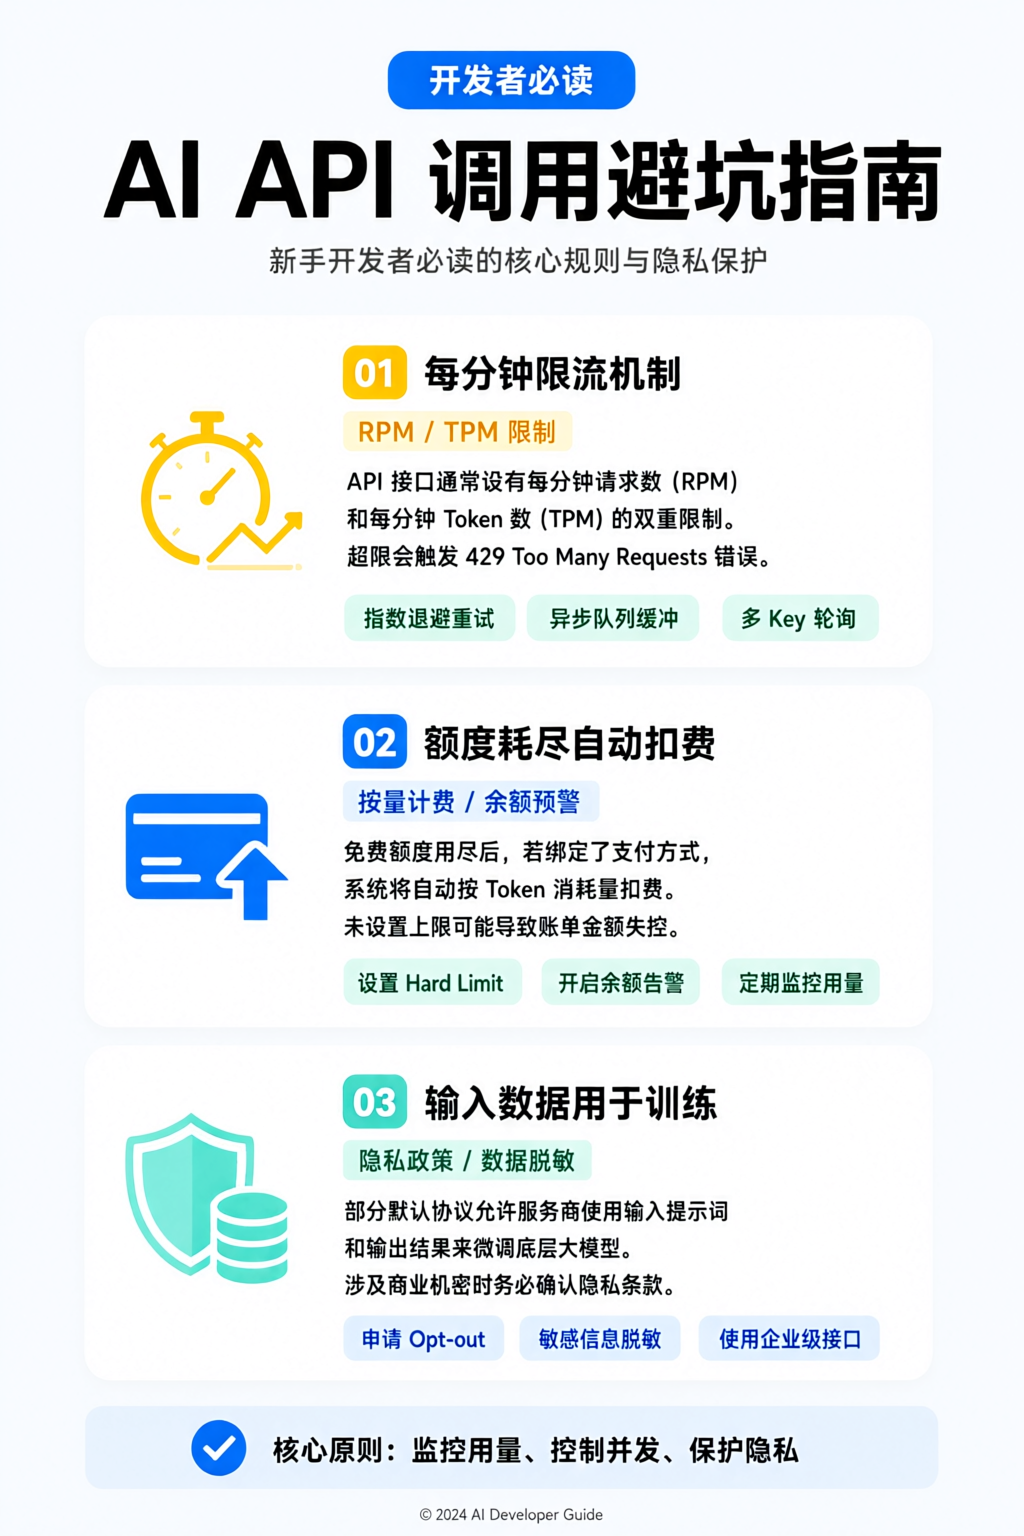
坑 1:限流是硬约束,不是「慢一点」
实测数字(开发者实测整理,2026):
- 商汤免费测试期给得相对大方:SenseNova 6.7 Flash-Lite 每 5 小时 1500 次,DeepSeek V4 Flash 每 5 小时 500 次。
- 魔搭社区号称每天 200 次免费调用,有开发者第一次对话就触发了 rate limit。
- 阿里百炼注册送 100 万免费额度,但一次多轮对话就烧掉一大截,「页面还没写完,额度已经见底」。
- 部分平台的免费层每分钟只有 20~30 次请求上限,撑不住真实用户并发。
- OpenRouter 免费档每日请求上限 50 次,充值满 10 credits 后跳到 1000 次——多账号刷额度不可行,速率限制是全局管理的。
做法:上线前按预期峰值压一遍测出真实并发;429 不一定是限流,也可能是上游容量不足,要按响应头里的 Retry-After 做指数退避重试。
⚠️ 避坑:开发环境一个人调用感觉不到,一上线并发起来就排队。别用「我本机测着挺快」判断它能不能扛业务。
坑 2:「免费额度用完自动转付费」是真会扣钱
做法:开通任何免费档之前,确认你走的是「纯免费、用尽即拒绝」那一档,不是「免费转后付费」那一档。
有开发者的实测很惨:因为调错了某个接入点,账户欠了费;而账户一欠费,名下所有模型全被锁,包括本来免费的那些(掘金,2026)。
⚠️ 避坑:如果你做的是给别人用的服务,这条要再升级——你的欠费会让客户一起断服。
坑 3:你在用免费模型,模型在用你训练
几乎所有提供免费模型的平台,都在用户协议里写了同一句话:我们可能会收集您的输入数据用于模型优化(开发者实测整理,2026)。
翻成人话:你用免费模型写的代码、整理的文档、贴进去的业务逻辑,都可能变成它下一版的训练语料。海外的情况也一样,有平台说明免费档输入可能被用于训练;Mistral 的免费层则要求用户同意数据用于模型训练。
做法(3 条底线):
- 客户的合同、报价、内部代码、含个人信息的资料,不要贴进免费档。
- 涉及用户数据的项目,先读服务协议里「是否用于训练、日志保留多久」两节,再决定接不接。
- 需要私密处理时,选付费档或明确零保留(zero-retention)的接口,把差价算进报价里。
⚠️ 避坑:更狠的一档是第三方中转站。今年 6 月国家安全部专门发布过 AI 中转站风险提示,提醒警惕无明确来源、无运营资质、无安全保障的平台(人人都是产品经理整理)。有人买到残留上一位使用者信息的账号,也有人在小中转站遇到「读你本地文件再悄悄发出去」的注入指令。省下的几十块,赔的可能是客户资料。
那免费档到底该怎么用?
它的正确位置是「兜底层 + 学习层」,不是「生产层」:
- 学习层:练提示词、跑小 demo、写脚本草稿。这一层免费额度完全够。
- 兜底层:有开发者把 GLM-4-Flash 当所有项目最底层的兜底——按官方说法永久免费、不限 token,只卡并发,能力在免费模型里偏弱,但胜在稳、国内直连、不会哪天突然收费(掘金,2026)。
- 生产层:付费 API + 必须做 fallback,主模型挂了自动切下一个,别把单点写死。
一份实操清单:
| 用途 | 该用什么 | 别做什么 |
|---|---|---|
| 自己学习、试想法 | 免费档、赠送额度 | 别拿它做长期规划 |
| 给客户交付的初稿 | 付费档为主 + 免费档兜底 | 别把客户敏感资料塞免费档 |
| 上线的产品功能 | 付费 + 重试 + 降级方案 | 别依赖任何单一免费模型 |
| 批量跑数据 | 先算 token 成本再开工 | 别用「自动转付费」的接口跑批 |
一套能直接抄的分层用法
把上面三个坑合起来,公开实测里跑通的组合长这样(掘金、CSDN、奇连 AI 整理,2026):
- 起步验证:用免费档跑通流程,一分钱不花,先确认「有没有人要」;
- 确定模型:有人付费之后,主力切到按 token 计费的接口,把 API 成本写进报价;
- 兜底不写死单点:保留一个稳定的免费模型(有开发者把官方称永久免费、不限 token 只卡并发的 GLM-4-Flash 当所有项目最底层兜底),主接口 429 时自动降级,且降级只跑非敏感部分;
- 敏感数据单独走:客户合同、报价、内部代码不进免费档——免费服务的数据条款通常和付费档不一样,是否用于训练、日志保留多久要自己读;
- 上线前压测一次:免费层每分钟 20~30 次的上限撑不住真实并发,按峰值压一遍再决定。
一句话总结这套用法:免费的正确位置是帮你确认「这事有没有人要」,不是帮你长期省钱。
最后说一句
免费无限大模型靠谱吗?用它学习和验证,靠谱;把它当成业务地基,不靠谱。该省的是「还没验证需求时的成本」,不该省的是「客户信任与数据安全」。
ctrl+D 收藏本站,下期更新:一个人做 AI 副业,工具每月到底要花多少钱。